WorkBuddy 模型怎么选?来看这一份省积分指南
上手 WorkBuddy 最容易踩的坑,是不知道自己在选什么。模型下拉框里,「快速 / 均衡 / 极致」和下面那十几个模型名挤在一起,看着像一回事,分属两层不同的东西。我头一遍翻官方文档也混了半天才理清。
积分怎么扣,官方只说了半句:消耗量=模型 Token 定价 × 任务复杂度。另半个乘数写在文档的别处——每一轮对话,系统都会把当前上下文完整重发给模型一遍。上下文越长,每一轮越贵。
下面按这个顺序写:先把选择器那两层分清,再看三档各接什么活,14 个内置模型怎么挑,最后是四个今天就能调的开关。
一、选择器里有两层:模式和模型
官方文档把模型选择器拆成两层写。上面那排「快速 / 均衡 / 极致」是第 1 层,模型模式,官方给的定位是「按任务复杂度选择」;下面能直接点名的,是第 2 层,内置模型,文档单独用一张表列了 14 个。
一个是「这类活该给多少算力」,一个是「具体用哪家的模型」。文档分开写,读者很容易看成一件事。
文档没说这两层能叠加,按「选一个」理解最保险:选模式是把调度权交给系统,直接点名模型是自己做主,积分按那个模型自己的定价扣。
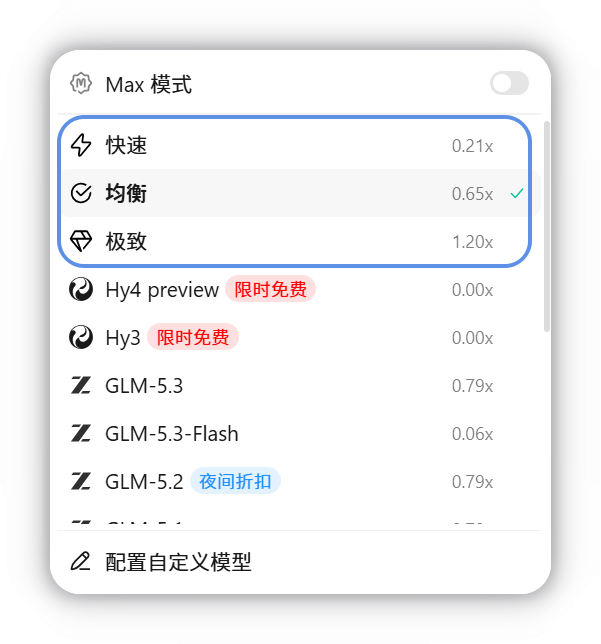
官方文档《模型配置》里的模型选择示意图。
二、三档按任务分,不按强弱分
官方表格写得很清楚,三档的定位是「按任务复杂度选择」。
快速模式接的是简单明确的任务——日常问答、格式转换、小段代码修改、文案润色。响应最快,消耗最低。
均衡模式覆盖绝大多数任务:写文档、分析数据、多文件代码改动。效果和速度兼顾,官方建议拿不准时用它。
极致模式留给复杂任务:跨模块重构、多步骤推理、需要反复验证的分析。响应稍慢,消耗更高,换来的是复杂任务下更稳的结果。
落到自己手上的活儿,我一般这么分。
快速档是一次成型的小活:改错字、统一格式、翻译一段话。
均衡档是结构固定、量不小的活:会议纪要、周报、数据分析、多文件改动。默认停在这儿。
极致档是错一次就要返工的活:终稿核对、跨文件重构、逻辑链条长的问题。
差多少钱?腾讯云开发者社区有一篇测算给了组系数:快速 0.21、均衡 0.65、极致 1.20。按「1 倍率≈1 积分/千 token」估算,一个 3.2 万 token 的标准任务,快速约 6.7 积分、均衡约 20.8、极致约 38.4。
从快速升到均衡贵 3.1 倍,从均衡升到极致只贵 1.85 倍。
系数是第三方推算的,作者自己写着「依据配置结构作出的判断,官方未逐条公示」。那篇文章里的模型清单还是 2026-10 的快照,和现在的官方表已经对不上。我手上也没有 WorkBuddy 的账单可以对照,所以这组数字只能帮你判断「差几倍」,别拿它算钱。
三、14 个模型,记住三个标记就够
官方内置模型表的每一行,后面都跟着「图片输入」「思考模式」「推理模型」这样的能力标记。挑模型不用背 14 个名字,先想三件事:要不要读截图、图表、扫描件?逻辑链条长不长?素材是不是超长文档?
筛完有两个事实值得单独记住。
读图能力是分化的:14 个里只有 10 个支持图片输入。 支持的是 Hy4 preview、Hy3、GLM-5.3、GLM-5.2、GLM-5v-Turbo、MiniMax-M3、MiniMax-m2.7、Kimi-K3、Kimi-K2.7-Code、Kimi-K2.6;GLM-5.3-Flash、GLM-5.1、Deepseek-V4-Flash、Deepseek-V4-Pro 这 4 个不支持。让它读一张截图,得到的往往是一句「我看不到图片」。
能调思考强度的只有 7 个。 Hy4 preview、Hy3、GLM-5.3、GLM-5.3-Flash、GLM-5.2、Deepseek-V4-Flash、Deepseek-V4-Pro 标的是「思考模式」;GLM-5.1、GLM-5v-Turbo、MiniMax-M3、MiniMax-m2.7、Kimi-K3、Kimi-K2.7-Code、Kimi-K2.6 标的是「推理模型」。文档里这是两种标记,前者你能调思考强度,后者是模型自带推理能力。
两个标记叠起来,省事的答案就出来了:GLM-5.3 和 GLM-5.2 读图、可调思考、1M 上下文都占。纯文本的大文件处理,Deepseek-V4-Flash 也行,它 1M 且速度优先,只是别指望它看图。
剩下这些模型的定位,官方简介里都写了一句,我照抄在下面这张表里,方便对照着挑:
| 模型 | 官方定位 |
|---|---|
| Hy4 preview | 混元新一代模型 |
| Hy3 | 混元思考模型,具有增强的推理能力 |
| GLM-5.3 | GLM 新一代模型,支持 1M 上下文窗口 |
| GLM-5.3-Flash | GLM 新一代模型的快速版本 |
| GLM-5.2 | 1M 上下文,擅长长程任务 |
| GLM-5.1 | 能力均衡,适合日常使用 |
| GLM-5v-Turbo | 原生多模态模型 |
| MiniMax-M3 | 原生多模态,擅长代码、智能体任务 |
| MiniMax-m2.7 | 能力均衡,适合日常使用,性价比高 |
| Kimi-K3 | 擅长处理复杂的长程自主任务,前端开发能力突出,在知识工作与科研推理上表现出色 |
| Kimi-K2.7-Code | 多模态模型,面向编程场景优化 |
| Kimi-K2.6 | 多模态模型,适合日常任务 |
| Deepseek-V4-Flash | DeepSeek 旗舰模型,支持 1M 上下文窗口,速度优先 |
| Deepseek-V4-Pro | DeepSeek 旗舰模型,支持 1M 上下文窗口 |
模型清单在变。腾讯云企业版文档(2026-09-07 更新)里的内置模型表还是上一代(Auto、Hy3、GLM-5.2、GLM-5.1、GLM-5v-Turbo、MiniMax-M3、Kimi-K2.7-Code、DeepSeek V4 系列、Kimi-K2.6)。照着两三个月前的文章抄名单,大概率抄错。
四、积分怎么扣
《积分说明》把一次消耗拆成两个因素:模型 Token 定价(高级模型单价更高)× 任务复杂度(推理计算量和处理量更大)。
第三个乘数是上下文长度,前面说过了——每一轮都要重发一遍。
套餐这边,2026 年 7 月 1 日起国内个人版改成了三档:
| 套餐 | 价格 | 每月实得积分 |
|---|---|---|
| 体验版 | 免费 | 500(写的是「Auto 模型调度,限免全模型可选」) |
| 标准版 | 99 元/月 | 4000(基础 2000 + 赠送 2000) |
| 高级版 | 199 元/月 | 9000(基础 4000 + 赠送 5000) |
| 旗舰版 | 999 元/月 | 50000(基础 20000 + 赠送 30000) |
| 加量包 | 50 元/包 | 1000,有效期 1 个月,不支持退款,也不结转 |
两条容易漏的规则。
赠送积分自到账日起 1 个月内有效,积分按月发放、当月不结转。不用就等于没有,月底清零。
WorkBuddy 和 CodeBuddy 同一账号积分共享。加入 Buddy One 并关联账号之后,腾讯文档、ima、腾讯网盘里的 AI 积分,跟 WorkBuddy 是同一份余额——《Buddy One 积分使用说明》里的原话是「同一份积分余额,实时共享」。
这条对个人最要紧:你在 WorkBuddy 里随手开的一个长会话,花掉的是你在腾讯文档、ima 里同一份额度。
想看明细,得去官网个人中心 → 套餐与用量 查。客户端头像 → 设置 → 套餐与积分 只看得到套餐本身。
粗算一笔:按上面那组第三方系数估算,体验版的 500 积分,在均衡档上大约够二十来个 3.2 万 token 的大任务,或者几百次快速档的小问答。够不够,取决于你一天要问多少句「帮我把这段话改一下」。
五、省积分的四个开关,按这个顺序动手
1. 该开新会话就开新会话
官方《高效使用小技巧》里有一条叫「不同的任务,开不同的会话」,说每个会话可以当成一张独立工作台。它还补了更实用的一句:会话过长,WorkBuddy 开始「前说后忘」「越聊越跑偏」,就别硬撑,直接开新任务,把关键背景重新简洁说一遍,往往比在旧上下文里反复修补更有效。
长会话有两个代价。上下文越滚越长,每一轮都在为前面的历史付钱;模型被无关的历史带偏,返工又是一笔输出。
2. 上下文档位:点输入框的「上下文用量」圆环
这是最容易被忽略的开关。点输入框里的圆环,弹出的面板底部能切档位:默认 / 适中 / 超长。
官方把这件事说得很直白:每一轮对话都会把当前上下文完整发送给模型,上下文越大,单轮消耗的积分就越多;窗口并非越大越好。
三条规则要记住:
- 档位越高,单轮积分消耗越大;
- 切换后立即保存,对话正在进行则从下一轮生效;
- 档位只对当前任务生效,换模型或新建任务后恢复为该模型的默认档位。
「设一次管全程」这件事不存在,长任务里得自己再切一次。官方的建议是保持默认档位,只在处理超长文档、或需要模型完整记住大量历史内容时才调大。
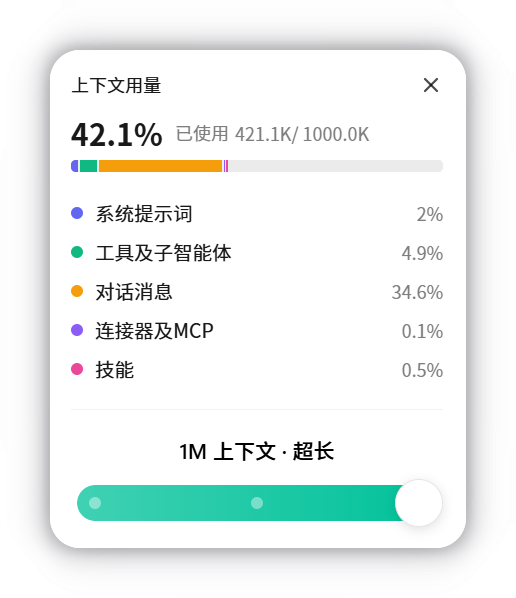
上下文档位在输入框的「上下文用量」圆环里,切换只对当前任务生效。
3. 经济模式:设置 → 智能体 → 经济模式
这里有个版本坑:原来模型面板里的「Max 模式」开关,已经搬到 设置 → 智能体 → 经济模式 了。个人版默认开启。
开启后,系统会在合适的时机自动压缩上下文,减少长对话里重复传输的内容;关闭后全程保留完整上下文、不做压缩,细节不丢,但长对话的积分消耗会明显增加。
官方建议保持开启,只在需要模型完整保留全部上下文时才关。版本升级不会覆盖你已有的选择。
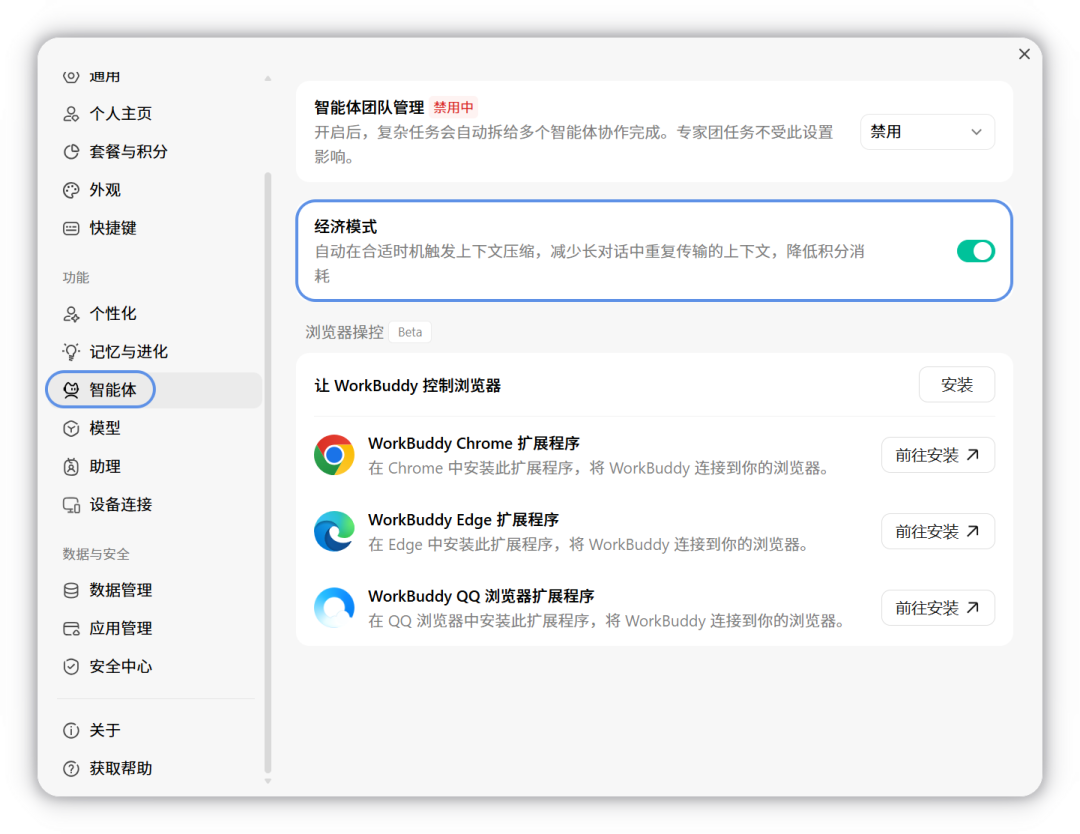
经济模式现在在「设置 → 智能体」里,不在模型面板里了。
4. 思考强度:默认就好,长链任务再调
思考强度是模型给出答案前的推理投入,可选等级取决于模型自身支持的档位。强度越高,模型做的分析和自我检查越多,适合逻辑链条长、容易出错的活儿;强度越低,倾向直接作答,响应更快。
官方说「已默认选择适合绝大多数任务的强度,一般无需单独调整」,这话我同意,大多数人应该从不动它。
有个细节值得知道:会话标题的自动生成是轻量的辅助调用,无论你用哪个模型,都不会开启思考模式,标题出得更快,也省了这部分的 Token。
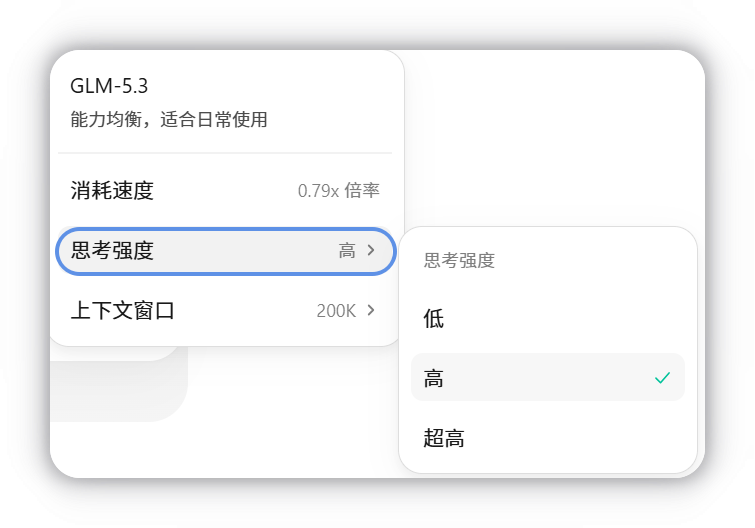
思考强度在模型设置里,选项多少取决于模型支持几档。
六、按任务查表
- 改格式、改错字、翻译一段话 → 快速模式
- 会议纪要、周报、数据分析、多文件改动 → 均衡模式(默认)
- 终稿核对、跨文件重构、长链条推理 → 极致模式
- 超长文档,或整个项目丢进去问 → GLM-5.3、GLM-5.2、Deepseek-V4-Pro 这类 1M 上下文的模型
- 读截图、图表、扫描件 → Hy4 preview、GLM-5.3、Kimi-K3、MiniMax-M3 等支持图片输入的模型,记得避开 DeepSeek V4 系列和 GLM-5.3-Flash
- 批量改写几十条文案 → 快速模式,或者直接点名轻量模型
- 写代码 → MiniMax-M3、Kimi-K2.7-Code,官方对这两个的定位分别是「擅长代码、智能体任务」和「面向编程场景优化」
遇到「读不了这个文件」,先别怀疑文件坏了。官方 FAQ 给的常见原因第一条就是「当前模型不支持对应文件类型」,处理办法是换一个支持图片或文档输入的模型。
七、几个坑
- 上下文档位只对当前任务生效。以为设一次能管全程的,每个新任务都会多付一笔。
- 模型下线会自动切换,你的思考强度和上下文档位不跟着走。官方规则是优先换同系列新模型(比如 Kimi-K3 下线换 Kimi 系列对应的新模型),没有对应的新模型就用系统默认模型,切过去之后思考强度和上下文窗口按新模型的默认值来。定时任务更明显:同系列没有新模型时,直接改用「快速」模式对应的默认模型。
- 自定义模型配不全会被置灰。没填接口地址或 API Key 的,列表里点不动,真发请求会报错误码 4100。指向本机的 Ollama 不需要 API Key,不受影响。
- 接第三方模型的费用你自己付,不走 WorkBuddy 积分。官方专门有一条:自定义模型产生的全部费用由你直接付给第三方。
- 模型会堵。选择器里悬停模型能看到繁忙程度:空闲(绿)、轻微拥堵(橙)、极度拥堵(红)、不可用。极度拥堵的模型,列表里名字旁边直接有个红图标。官方建议换模型,繁忙程度仅供参考,不阻止你选。
- 网上的倍率表别全信。像 0.21 / 0.65 / 1.20 这类数字,都是第三方按客户端配置推算的,官方没有逐条公示,模型清单还是某个月的快照。
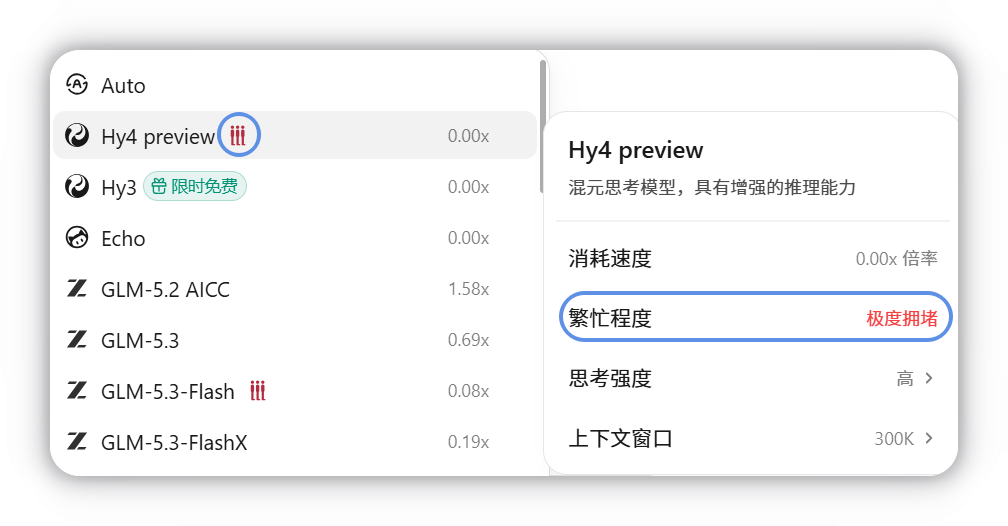
模型列表里的红色图标表示这个模型此刻极度拥堵。
八、自己接模型,什么时候值得
WorkBuddy 支持接第三方模型当底座,配置(含 API Key)只存在本地 workbuddy/models.json,不上传云端;WorkBuddy 只做通信链路,输入直达第三方模型。
三条路。
腾讯云 Token Plan 走的是官方通道,兼容混元、MiniMax、Kimi、GLM 等,文档里说是专为 AI 编程和 WorkBuddy 场景做的;另有 Coding Plan,腾讯云、智谱、Kimi 三家在售。
本地 Ollama 是另一条路,装完之后在本地监听 11434 端口,提供兼容 OpenAI 协议的接口。官方列的适用场景有三条:数据不出本机,金融、政企、内网合规的场合用得上;零成本试用,不消耗 Token,也不用付费 API Key,把自己的硬件当算力;以及离线可用。
第三种是自定义 API。服务不在上面列表里的话,手填 URL、API Key 和模型名就行。
值得折腾的情况就两种:材料涉敏、不能出本机;或者你本来就有 Token Plan / Coding Plan,额度别浪费。代价也摆在那儿——算力自备、可用性和稳定性看第三方的脸色、费用自己盯着。
九、我自己的默认设置
- 默认停均衡,只有终稿核对、跨文件重构才上极致。
- 一个任务一个会话,聊长了就换新的,把关键背景重说一遍。
- 上下文档位留在默认档,经济模式开着,思考强度不动。
我把三档模式、14 个内置模型的能力标记和按任务查档位的表,整理成了一份速查清单。
回复关键词「选型」领取。
本文依据 WorkBuddy 官方文档《模型配置》《积分说明》《定价详情》《高效使用小技巧》与腾讯云开发者社区第三方测算整理,资料核对时间为 2026 年 11 月 19 日,对应客户端 5.11.3。模型清单与积分规则会随版本更新变动,以官方文档为准。
评论